LangGenius では、Dify を開発するだけでなく、社内の業務や運用でも Dify を使っています。
そのため、私たちは Dify の開発者であると同時に、Dify を日々使う利用者でもあります。社内で workflow や chatflow などの Dify App が増えてくると、運用側では自然にいくつかの問いが出てきます。
- 先月、どの App のコストが高かったのか?
- 最近トークン使用量が増えているモデルはどれか?
- ある App のコストは、主にどのノードで発生しているのか?
- OpenAI、Gemini、Anthropic などの provider は、実際にはどれをよく使っているのか?
これらは、特別に複雑な問いではありません。
ただ、実際に確認しようとすると、「どこを見ればよいのか」「誰に依頼すればよいのか」という小さな摩擦が生まれます。
LLM provider の dashboard を見れば、アカウント単位の請求額や利用量は確認できます。しかし、それだけでは、そのコストが Dify 上のどの App、どのモデル、どのノードで発生しているのかまでは分かりにくいです。
一方で、データベースにアクセスして SQL を実行すれば、より詳しく確認できます。ただ、日常的な確認のたびに、SQL を書ける人や運用担当者に依頼するのは少し重いです。
そこで LangGenius 社内では、この確認をもう少し軽くするために、小さな Dify App を作りました。
社内では、この App を「コスト係」と呼んでいます。Dify App のコストや利用状況について、まず気軽に聞ける小さな担当者のようなものです。
Dify の文脈でコストを見る
「コストを見るなら、OpenAI や Anthropic などが提供する dashboard を見ればよいのでは?」と思うかもしれません。
もちろん、それらの dashboard は必要です。アカウント全体の請求額や利用量、上限管理を見るには適しています。
ただし、OpenAI や Anthropic などが提供する dashboard が見ているのは、基本的には provider 側の利用状況です。Dify 上でその呼び出しがどの App から来たのか、どのモデル設定やノードに関係しているのか、最近変更した workflow と関係があるのか、といった文脈までは見えにくいです。
例えば、ある月にモデル利用料が大きく増えていたとしても、業務側が知りたいのは金額そのものだけではありません。
- どの Dify App で発生したのか?
- どのモデルや provider の利用が増えているのか?
- 特定のノードや処理が主な要因なのか?
- 最近変更した workflow と関係があるのか?
「コスト係」の役割は、このような情報を Dify の文脈に戻して確認できるようにすることです。
「コスト係」に聞いてみる
例えば、Dify の WebApp で次のように聞きます。
直近 7 日間のトークン消費量トップ 10 を教えてください。
実際の画面では、次のように App ごとのトークン消費量を自然言語で確認できます。
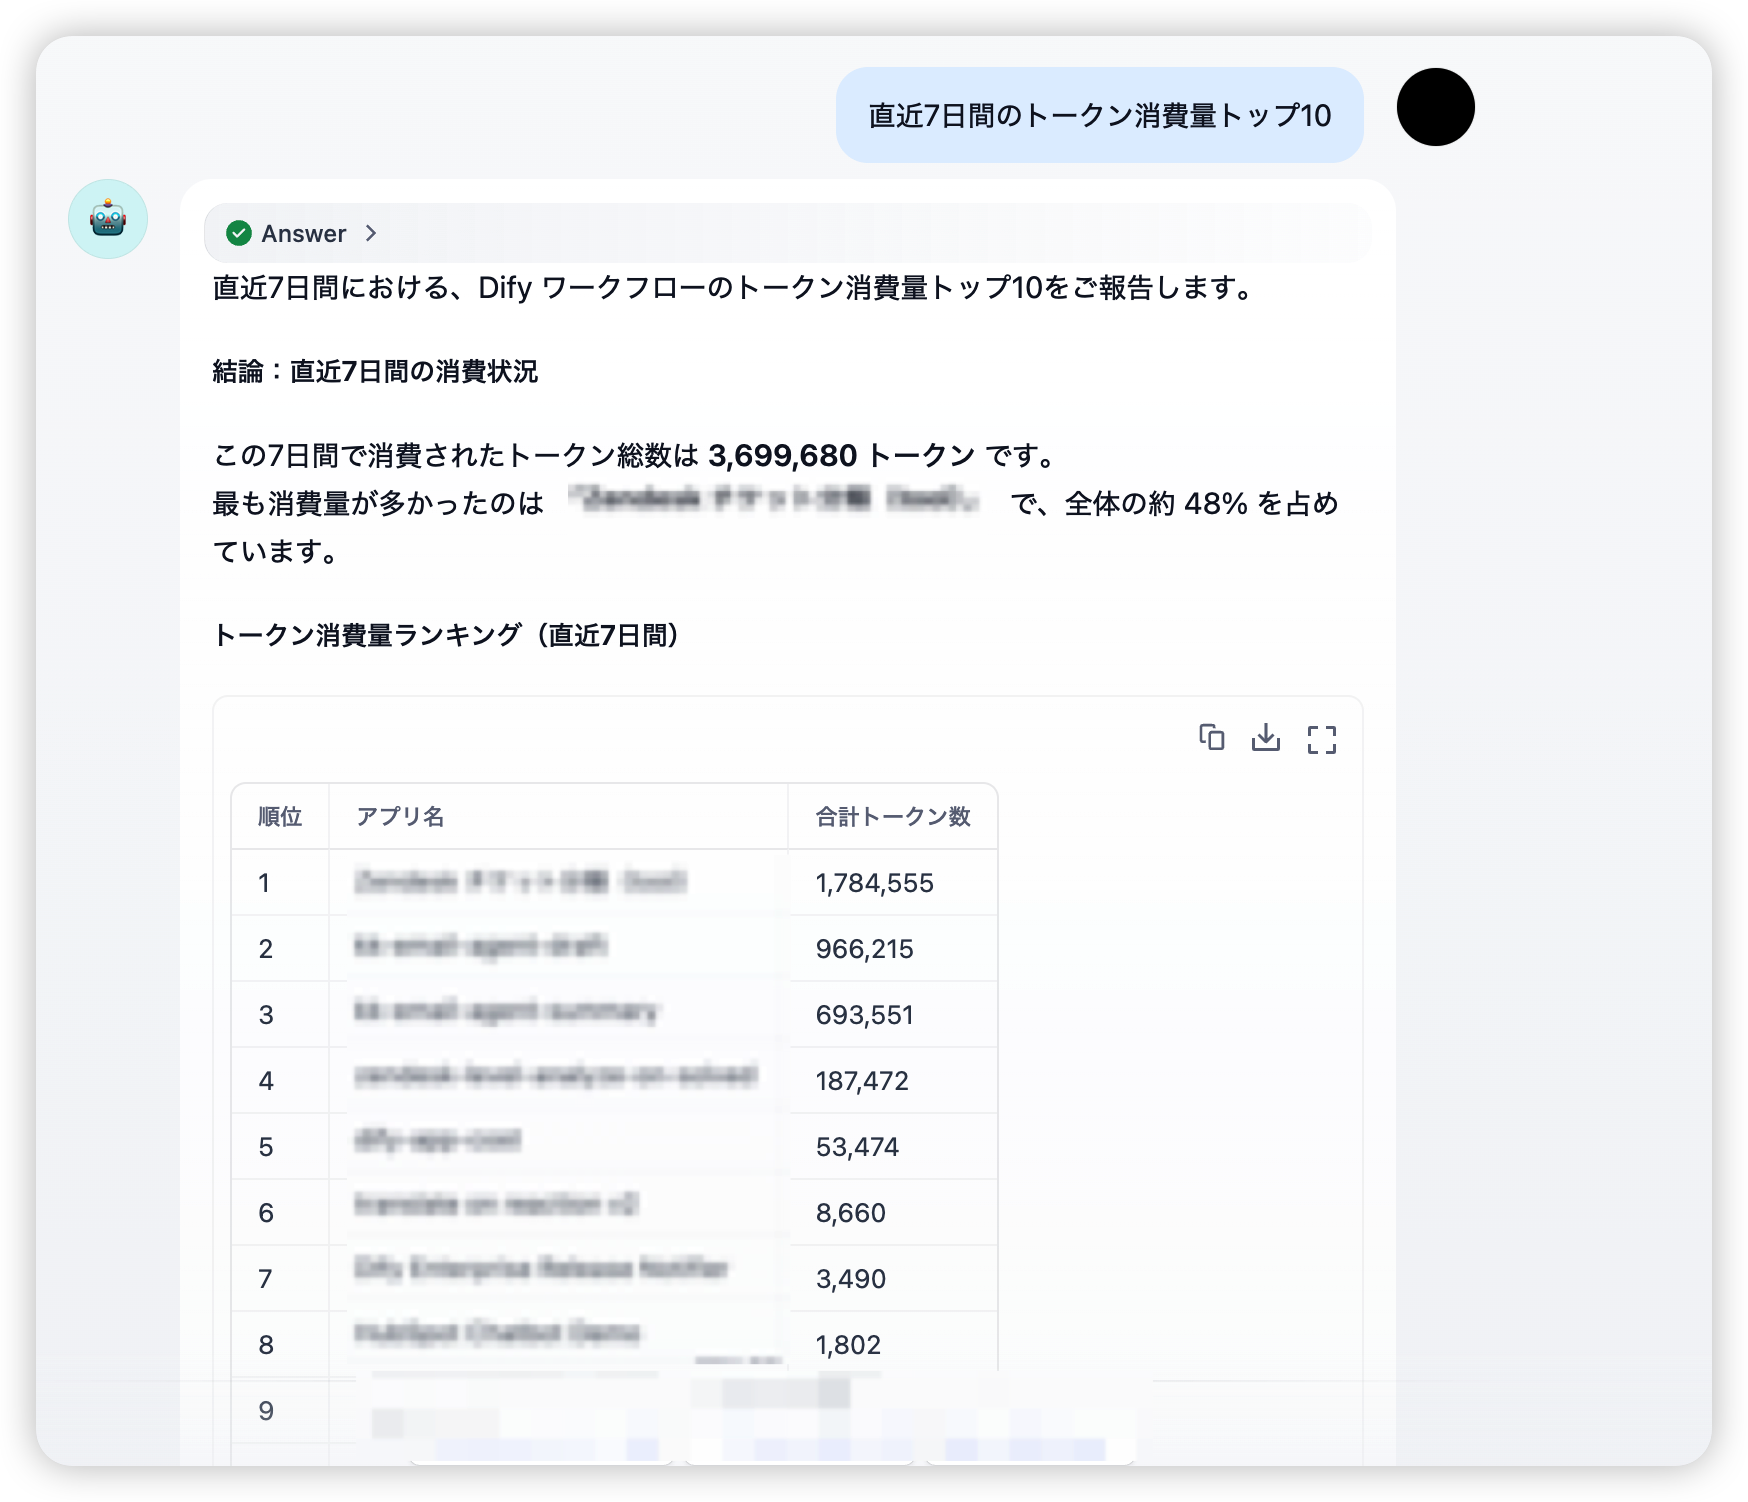
「コスト係」は、単に合計トークン数を返すだけではありません。App ごとのトークン消費量、利用モデル、消費が大きい処理、確認したほうがよいポイントをまとめて返します。
このように、正式な dashboard を作る前の段階でも、まず自然言語で状況を把握できます。
自然言語から読み取り専用 SQL へ
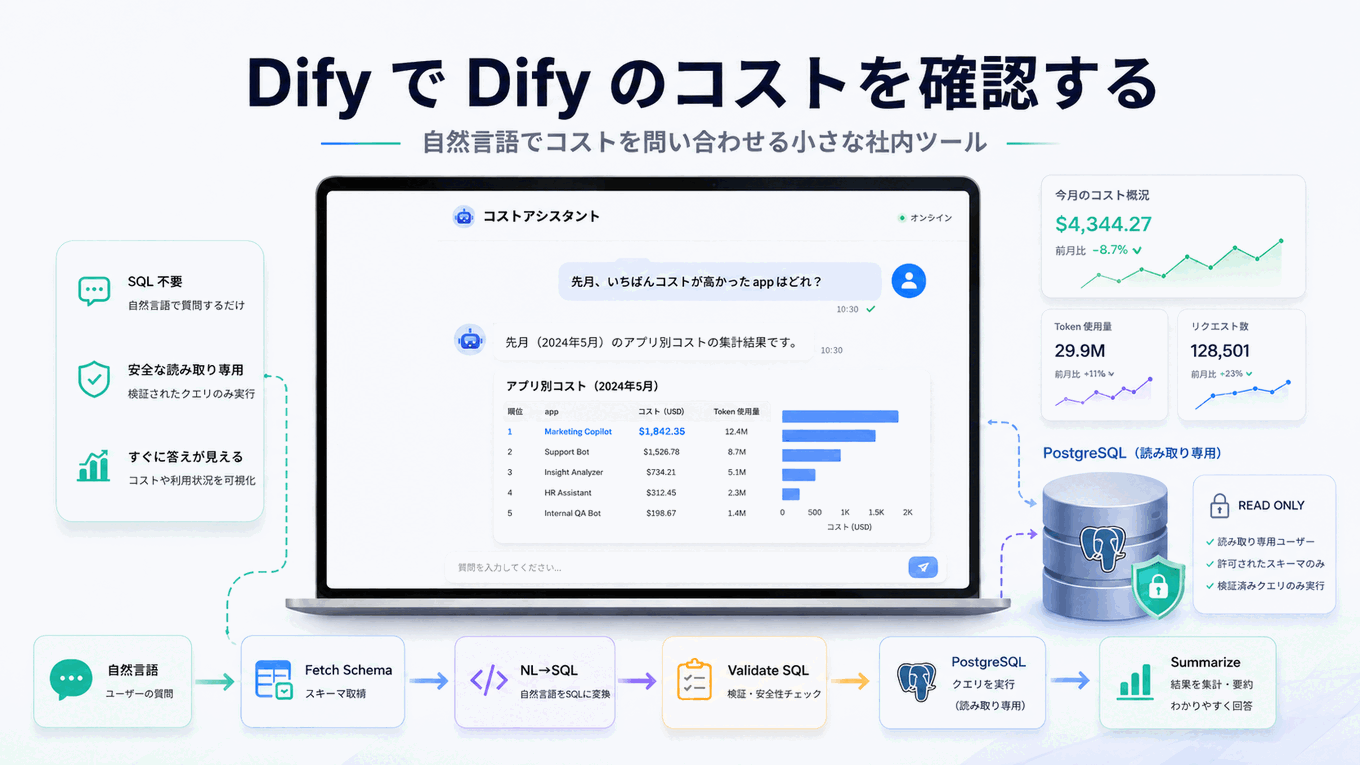
「コスト係」は、Dify App として作った小さな社内向けのチャットです。基本的な流れはシンプルです。ユーザーが自然言語でコストや利用状況に関する質問を投げると、Dify がそれを読み取り専用 SQL に変換し、自身の PostgreSQL を引き、結果を再び自然言語に戻します。
全体の流れはこうなっています。
Start
ユーザーが WebApp に自然言語で質問を入力
   ↓
Fetch Schema
information_schema から Dify 自身の PG schema を取得
   ↓
Format Schema
LLM が読みやすいテキストブロックに整形
   ↓
LLM #1 · NL → SQL
schema + few-shot + 業務ルールを使って PostgreSQL を生成
   ↓
Validate SQL
テーブル ホワイトリスト + 禁止語 + 強制 LIMIT
   ↓
SQL Query
読み取り専用ユーザー dify_readonly で SQL を実行
   ↓
LLM #2 · Summarize
クエリ結果を自然言語に戻す
   ↓
Answer
ここで最も重要なのは、「セキュリティと特権の最小化」です。Dify 自体が魔法のように安全な SQL 生成を行ってくれるわけではないため、セキュリティの第一防線は、必ずデータベース(PostgreSQL)側に置く必要があります。
具体的には、データベース側に dify_readonly という読み取り専用ユーザーを作成し、コスト確認に必要な 7 つのテーブルに対してのみ GRANT SELECT を実行しました。その上で、Dify のワークフロー側に「テーブルのホワイトリスト制限」「危険な語句のフィルタリング」「自動的な LIMIT 句の追加」といった第二の防御壁を構築しています。これにより、仮に LLM が誤った SQL や予期せぬクエリを生成したとしても、影響範囲は「完全に読み取り専用、かつ制限されたテーブルの範囲内」に厳密に閉じ込められます。
実装で気をつけたこと
最初に動く状態まで持っていくのに、だいたい 90 分ほどかかりました。大きな実装ではありませんが、NL → SQL のワークフローとして使うには、いくつか設計上の注意が必要でした。
特に意識したのは、LLM に SQL を自由に書かせることではなく、実行できる範囲をあらかじめ狭くしておくことです。
具体的には、次のような制約を置きました。
- データベース側では読み取り専用ユーザーを使う
- 参照できるテーブルを必要なものに限定する
- workflow 側で危険な SQL や想定外のテーブル参照を弾く
- 結果が大きくなりすぎないように LIMIT を強制する
- モデルには PostgreSQL として実行可能な SQL を生成させる
NL → SQL は便利ですが、生成された SQL をそのまま信頼する前提にはできません。Dify 側の workflow で制御するだけでなく、データベース側でも権限を最小化しておくことが重要です。
このあたりは、Dify で社内データに接続する App を作るときに共通する考え方だと思います。まずは小さくつなぎ、読み取り専用で試し、実行範囲を明確にしたうえで、必要に応じて対象を広げていくのが安全です。
できること、できないこと
「コスト係」が動くようになると、確認の入口はかなり軽くなります。
ユーザーはテーブル名や SQL を知らなくても、次のように続けて聞くことができます。
直近 7 日間のトークン消費量トップ 10 を教えてください。
そのうち、特定の App ではどのモデルの利用が多いですか?
今月のトークン消費量は先月よりどれくらい増えましたか?
チャット形式なので、前の質問の流れに乗ったまま追加確認できます。
一方で、「コスト係」は正式な会計レポートや長期的な dashboard を置き換えるものではありません。複雑なグラフを作る、安定した月次レポートを出す、監査用途の数値を管理するといった用途には、正式なレポートや専用の可視化ツールの方が向いています。
役割としては、もっと手前です。まず状況を知る、気になる App を見つける、次に確認すべきポイントを把握する。そのための軽い入口として使っています。
位置づけ:Langfuse や Metabase の代替ではない
今回の「コスト係」は、Langfuse や Metabase の代替ではありません。それぞれ役割が違います。
| ツール | 強み | 向かないところ |
|---|---|---|
| Langfuse | trace / span / per-call cost、呼び出しチェーン分析、深い可視化 | 業務の言葉でラフに質問する用途には向かない |
| Metabase | dashboard、グラフ、定期的な数値確認、推移確認 | 使う側にデータ構造や集計条件の理解が必要 |
| コスト係(Dify) | 自然言語の質問、文脈ありの対話、業務の言葉での確認 | 複雑なグラフ、正式な会計レポート、長期レポートには不向き |
つまり、どれか一つを選ぶというより、目的に応じて使い分ける関係です。
Langfuse は trace や span を深く見るために使う。Metabase は dashboard や定期的な数値確認に使う。「コスト係」は、その手前で、まず業務の言葉でざっくり状況を確認するために使う。
dashboard を探して filter を操作するほどではないけれど、少し数字を見たい。SQL を書くほどではないけれど、どの App が増えているのか知りたい。そういう日常の小さな確認に、自然言語で聞ける入口があると便利です。
いま、ちょっと数字が知りたい。SQL は書きたくないし、dashboard を探し回るのも面倒。業務の言葉のまま聞かせてほしい。
これは派手な問題ではありませんが、現実にはよくあります。そして、自然言語、業務文脈、ツール呼び出し、結果の自然言語化を一連の流れにできるという点で、Dify が得意な領域に近いと感じています。
LangGenius として得られた学び
今回価値があったのは、「コスト係」という小さな App ができたことだけではありません。
LangGenius 自身が Dify を業務の中で使うことで、Dify を使う方がどこでつまずきやすいのか、どのような設計にすると実務に近づくのかを、具体的に確認できました。
Dify の利用者にとって、最初から大きな業務システムを作る必要はない場面も多いはずです。まずは小さな App として作り、実際のデータに接続し、利用者が自然に聞ける形にしてみる。その過程で、Dify が得意なことと、追加の設計が必要なことが見えてきます。
今回で言えば、特に次の点を確認できました。
- 自然言語で業務データに近づく入口は作れる
- ただし、権限や実行範囲は明示的に制限する必要がある
- 頻出する質問はテンプレート化した方が安定する
- 小さく作って試すことで、改善すべき点が見えやすくなる
「コスト係」は小さな社内 App ですが、Dify を社内業務に使ううえで、良い検証材料になりました。
次の一歩
ここから先、試したいことが二つあります。
1. テンプレート化された SQL。
NL → SQL は柔軟ですが、その柔軟さは不確実性も伴います。「先月いちばんコストが高かった App」「今月いちばんトークン消費量が伸びたモデル」のような頻出パターンは、SQL テンプレートにしてしまい、LLM には意図の特定とパラメータの埋め込みだけ任せる方が安全です。
2. マテリアライズドビューによる事前集計。
毎回元テーブルを走査する必要のない問い合わせもあります。App / モデル / 日付であらかじめ集計しておき、「コスト係」には集計済みテーブルを引かせる方が、クエリは速く、SQL もシンプルになります。
このワークフローを構築するための DSL テンプレート(YAML 形式)は、本記事の最下部からダウンロードできます。ご自身の環境で試す場合も、まずは読み取り専用ユーザーと限定されたテーブルから始めるのがおすすめです。